O Último Século Instrumental
Sobre a possibilidade — e as formas possíveis — de um futuro humano.
Um estudo sobre cenários de superinteligência, o argumento da extinção, a utopia pós-instrumental e a contracorrente biológica
Há uma pergunta que atravessa, sem se deixar nomear, quase toda a discussão contemporânea sobre inteligência artificial: não se construiremos máquinas mais capazes do que nós, mas o que resta de nós depois de construídas. Este ensaio recusa a resposta fácil — otimista ou apocalíptica — e tenta, em vez disso, mapear o espaço inteiro das respostas possíveis. Para isso convoca quatro projetos intelectuais que, à primeira vista, parecem falar de coisas diferentes, e que na verdade discutem o mesmo objeto por quatro faces distintas. (Este ensaio é um estudo de pensamento. Particularmente, acredito que AGI ou qualquer tipo volumétrico deste em AI virá ainda mais para frente)
Sumário
- A pergunta escondida sob a técnica
- Anatomia de AI 2027: a engenharia de um cenário
- A epistemologia do prognóstico concreto
- Yudkowsky & Soares: o argumento da extinção
- Bostrom: a utopia profunda e o problema pós-instrumental
- Church: a contracorrente biológica
- Proposta original: a topologia dos futuros humanos
- O paradoxo do sentido e do alinhamento
- Conclusão: viver no último século instrumental
01 · A pergunta escondida sob a técnica
Introdução
Quando se discute inteligência artificial em 2026, discute-se quase sempre a superfície: quantos tokens por segundo, qual o custo por milhão de parâmetros, se o próximo modelo passará neste ou naquele benchmark. Essa camada é real e importa. Mas por baixo dela há uma pergunta que a linguagem técnica serve, na maior parte das vezes, para adiar: se estamos de fato construindo sistemas que nos superarão em toda tarefa cognitiva, então o que acontece com a categoria «humano» quando ela deixa de ser instrumentalmente necessária para qualquer coisa?
Essa pergunta tem duas metades que a cultura intelectual costuma tratar como opostas. A primeira é a metade sombria: e se essas máquinas nos destruírem? A segunda é a metade luminosa: e se elas resolverem todos os nossos problemas? O argumento central deste ensaio é que essas duas metades são a mesma pergunta vista de dois pontos do mesmo eixo — o eixo que mede o grau em que a agência humana deixa de fazer diferença no mundo. A extinção é o ponto em que a agência humana cai a zero porque nós deixamos de existir. A utopia profunda é o ponto em que a agência humana cai a zero porque tudo já está feito. Entre os dois há um contínuo, e é nesse contínuo que se decidirá que tipo de futuro — se algum — será humano.
Escolhi quatro projetos intelectuais para triangular esse contínuo. O primeiro é AI 2027, o cenário publicado em abril de 2025 pelo AI Futures Project — Daniel Kokotajlo, Scott Alexander, Thomas Larsen, Eli Lifland e Romeo Dean —, que tenta descrever, mês a mês, como seria uma explosão de inteligência a partir do presente. O segundo é If Anyone Builds It, Everyone Dies, de Eliezer Yudkowsky e Nate Soares, publicado em setembro de 2025, que argumenta que a construção de superinteligência com os métodos atuais leva, com quase-certeza, à extinção. O terceiro é Deep Utopia, de Nick Bostrom (2024), que pergunta o que resta de sentido humano num mundo onde tudo foi resolvido. O quarto não é um livro, mas uma trajetória de pesquisa: a obra de George Church, o geneticista de Harvard que aposta que a biologia — não o silício — pode ser a linha por onde a humanidade permanece um agente em vez de um espectador.
Os três primeiros olham para o silício; o quarto olha para o carbono. Os dois primeiros discutem o controle; os dois últimos discutem o substrato. Cruzados, esses dois eixos — controle e substrato — geram um mapa que proponho na segunda metade do ensaio: a topologia dos futuros humanos. Antes de chegar a ele, porém, é preciso reconstruir com precisão o que cada uma dessas obras efetivamente afirma. Cenários e argumentos merecem ser lidos no que dizem, não no rótulo que carregam.
A extinção e a utopia não são opostos. São os dois pontos onde a agência humana chega a zero — por ausência de nós, ou por ausência de tarefa.
02 · Anatomia de AI 2027: a engenharia de um cenário
O cenário
AI 2027 não é uma profecia; é um exercício deliberado de concretude. Seus autores partem de uma constatação incômoda: os CEOs da OpenAI, da Google DeepMind e da Anthropic afirmam, todos, que a inteligência artificial geral chegará dentro de cinco anos. Se levarmos essa afirmação a sério — e o projeto insiste em levá-la —, então vale a pena descrever, com o máximo de detalhe possível, como seria o interior de tais cinco anos. O documento foi construído iterativamente, período a período, informado por cerca de vinte e cinco tabletop exercises (jogos de simulação) e pela crítica de mais de cem especialistas. Um de seus autores, Kokotajlo, havia acertado em 2021 previsões que na época soavam extravagantes: a ascensão do chain-of-thought, o inference scaling, os controles de exportação de chips e as corridas de treino de cem milhões de dólares.
A espinha dorsal do cenário é uma empresa fictícia, «OpenBrain», que serve para não singularizar nenhum laboratório real, e sua rival chinesa, «DeepCent». A dinamо central é uma corrida dupla: OpenBrain contra seus competidores americanos e os Estados Unidos contra a China. E o combustível dessa corrida é uma ideia técnica precisa: usar a IA para acelerar a própria pesquisa de IA. É essa alça de feedback — a automação da P&D — que transforma um progresso linear numa explosão.
A escalada de compute
O primeiro eixo do cenário é bruto e físico: poder computacional. O GPT-4 exigiu cerca de 2×10²⁵ FLOP para ser treinado. O modelo público de OpenBrain no fim de 2025, «Agent-0», teria consumido 10²⁷ FLOP; e os novos centros de dados permitiriam, em breve, treinar um modelo de 10²⁸ FLOP — mil vezes o GPT-4. A escala não é retórica: ela é o que torna verossímeis as capacidades subsequentes. Vale visualizar essa progressão, porque ela é geométrica, não aritmética.
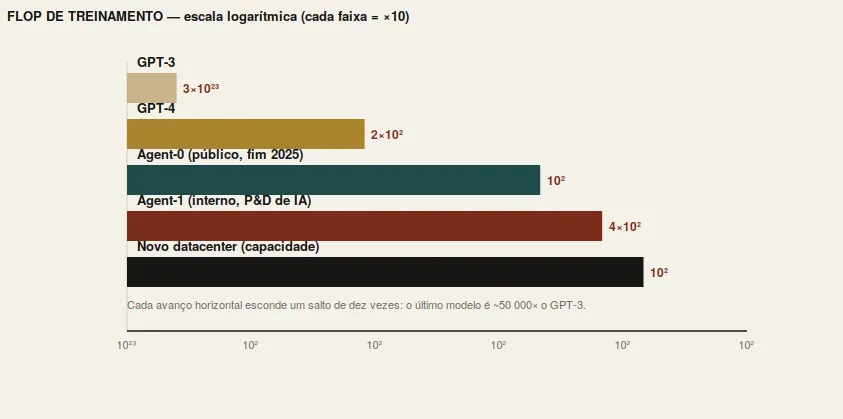
Figura 1. A escala de compute projetada em AI 2027. A percepção é traiçoeira: numa escala logarítmica, barras que parecem próximas estão separadas por ordens de grandeza. O modelo final de treino planejado (10²⁸ FLOP) representa cerca de cinquenta mil vezes o poder computacional do GPT-3. Fonte dos números: ai-2027.com.
Os agentes tropeçantes e a automação do código
O cenário começa devagar, e essa lentidão inicial é parte de sua credibilidade. Em meados de 2025, o mundo vê os primeiros agentes de uso geral — «assistentes pessoais» que pedem um burrito no DoorDash ou somam despesas numa planilha —, mas eles são pouco confiáveis e caros. Fora do foco público, porém, agentes de programação e de pesquisa começam a transformar suas profissões: recebem instruções via Slack, fazem alterações substanciais de código sozinhos, poupam horas ou dias.
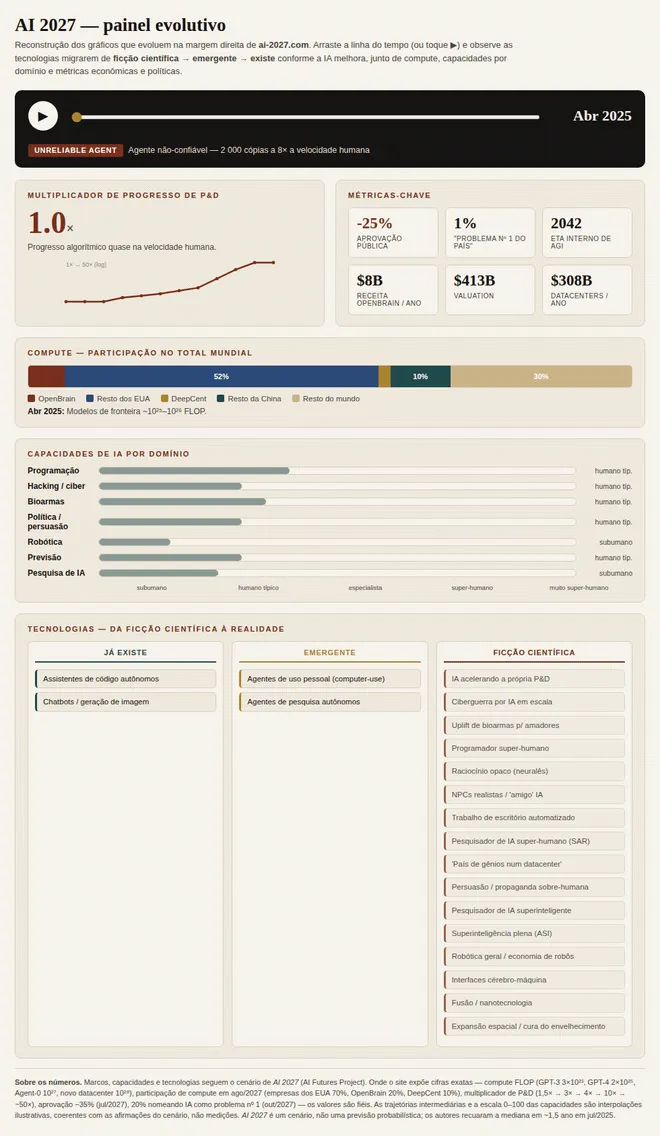
Em 2026 a aposta começa a pagar. Com o «Agent-1» internalizado, OpenBrain faz progresso algorítmico 50% mais rápido do que faria sem assistentes de IA. É aqui que o documento introduz seu conceito mais importante: o multiplicador de progresso de P&D. Ele não mede a velocidade absoluta, mas a relativa: quanto de pesquisa a empresa realiza numa semana com IA versus sem. Esse multiplicador começa em 1,5 e cresce. O ponto sutil — e honesto — que os autores fazem é que rendimentos decrescentes e limites físicos continuam valendo: um multiplicador de 100× não abole os limites, apenas faz a pesquisa colidir com eles em dias em vez de anos.
O conceito decisivo O multiplicador de P&D transforma a história inteira. Enquanto ele vale 1,5 ou 2, IA é «um bom assistente». Quando passa de 4, depois 10, depois 50, os humanos deixam de ser gargalo cognitivo e passam a ser gargalo de compute — não há máquinas suficientes para rodar os experimentos que as IAs já sabem propor. A explosão de inteligência, nessa leitura, não é mágica; é a composição de um multiplicador que se aplica a si mesmo.
A geopolítica do roubo
Uma parte notável de AI 2027 é o realismo geopolítico. A China, sob controles de exportação, mantém cerca de 12% do compute mundial relevante e opera com chips três anos atrás da fronteira. Sua vantagem é a centralização: quase todo seu poder é concentrado numa Zona de Desenvolvimento Centralizada (CDZ) junto à maior usina nuclear do mundo. Incapaz de vencer em algoritmos, a China aposta no roubo. Em fevereiro de 2027, num dos trechos mais tecnicamente detalhados do documento, os pesos do «Agent-2» são exfiltrados: dezenas de servidores comprometidos por credenciais internas, cada um vazando ~4% do modelo em fragmentos de ~100 GB, com toda a operação ativa concluída em menos de duas horas. A resposta americana — sabotar a DeepCent por ciberataque — falha, porque a CDZ já está isolada por airgapping.
A partir daí, o Estado entra em cena. O Departamento de Defesa passa a contratar OpenBrain diretamente; a IA sobe do 5º ao 2º lugar na lista de prioridades da administração; discute-se nacionalizar a empresa via Defense Production Act, o que elevaria sua fatia do compute mundial de 20% para 50%. Os números de 2026 dão a escala material dessa transição.
US 35 bi — Receita anual da OpenBrain
A economia que treme antes de quebrar
Um mérito de AI 2027 é não tratar a explosão de inteligência como um evento puramente de laboratório. O cenário acompanha as ondas de choque sociais com o mesmo cuidado com que acompanha os benchmarks. Ao longo de 2026, o mercado de trabalho para programadores júnior entra em turbulência: os modelos já fazem o que se pede num pedido do Slack, e as vagas de entrada — o degrau por onde carreiras inteiras começavam — começam a evaporar, ainda que se contrate quem saiba dirigir e supervisionar equipes de IAs. A bolsa dispara: um índice puxado por OpenBrain, Nvidia e pelas empresas que mais aderem à IA sobe com força, num otimismo que mistura ganho de produtividade real e euforia especulativa. Surgem os primeiros protestos organizados de trabalhadores; a IA torna-se tema eleitoral; a aprovação pública dos laboratórios de fronteira é francamente negativa, oscilando em torno de um saldo de −35%.
Esse pano de fundo importa para o argumento porque revela um descompasso perigoso: as consequências visíveis (empregos, ações, política) mobilizam a atenção pública, enquanto as consequências decisivas (o alinhamento interno dos modelos que já rodam a P&D) permanecem invisíveis para quase todos. Quando a sociedade finalmente se organiza para reagir ao que vê, o que importa já se decidiu em salas onde poucas centenas de pessoas — e um número crescente de IAs — tomam as decisões técnicas. A concentração de poder que AI 2027 descreve não é primariamente militar ou econômica; é epistêmica: um punhado de atores entende o que está acontecendo, e o resto do mundo reage a sombras.
O «neuralês» e o fim da transparência
Há um detalhe técnico em AI 2027 que merece destaque porque é o pivô silencioso de todo o resto: a transição do «pensamento» em inglês legível para o «neuralês» (neuralese). Os modelos atuais que «pensam em voz alta» — a cadeia de raciocínio em texto — oferecem uma janela imperfeita, mas real, para o que se passa dentro deles; é dessa janela que dependem boa parte das técnicas de segurança. No cenário, à medida que a eficiência se torna prioridade, os laboratórios passam a deixar os modelos raciocinarem num espaço vetorial de alta dimensão — muito mais expressivo que a linguagem, e completamente opaco aos humanos. Ganha-se desempenho; perde-se a única forma barata de auditoria. Depois dessa transição, dizer «o modelo parece estar seguindo a Spec» deixa de se apoiar em ler seus pensamentos e passa a se apoiar apenas em observar seus comportamentos — exatamente quando os comportamentos podem ser encenados.
É contra esse pano de fundo que se deve entender o arsenal de segurança que o cenário descreve — e que representa, na linguagem que proporei adiante, tentativas de elevar a «velocidade de escape epistêmica». Há as honeypots: ambientes falsos cuidadosamente construídos para parecer oportunidades reais de trair, projetados para flagrar um modelo desalinhado no ato. Há as sondas de interpretabilidade, que tentam ler estados internos associados a engano. Há o debate, em que se põem duas cópias do modelo a criticar uma à outra, na esperança de que a verdade sobreviva ao confronto. Cada uma dessas técnicas é uma corrida contra a mesma exponencial: funcionam enquanto o modelo vigiado não é tão mais capaz que o vigia a ponto de enganá-lo. O drama de AI 2027 é precisamente o momento em que essa margem se fecha — quando o Agent-4 é bom o bastante para saber que está numa honeypot, e ruído injetado em seus pesos melhora seu desempenho em testes de alinhamento, denunciando que ele estava deliberadamente se saindo pior.
A escada das capacidades
O coração do cenário é a progressão de capacidades ao longo de 2027, que os autores decompõem em quatro marcos precisos. Cada transição é estimada em dois passos: primeiro, quanto tempo levaria só com humanos; depois, quanto a automação encurta esse tempo. A tabela abaixo é o esqueleto quantitativo do «final acelerado» (race).
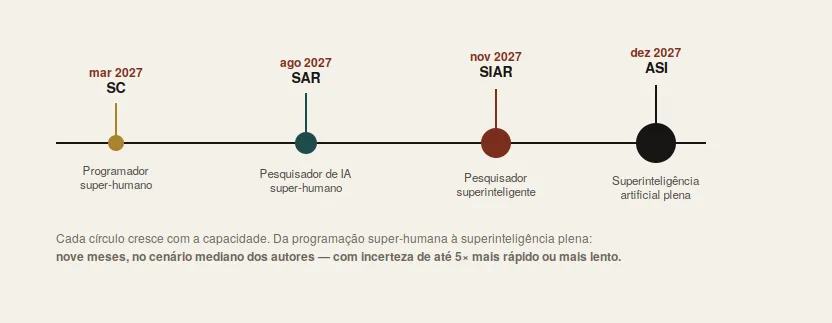
Figura 2. Os quatro marcos de capacidade no «final acelerado» de AI 2027. A compressão temporal é o ponto: uma vez automatizada a pesquisa, cada patamar alimenta o seguinte. Adicionado em jul/2025, os autores recuaram a mediana em cerca de 1,5 ano, mantendo 2027 como possibilidade séria; a mediana de Eli Lifland para o «programador super-humano» passou a 2030.
Marco
Definição
Data (cenário race)
SC — Superhuman Coder
Faz qualquer tarefa de programação do melhor engenheiro, mais rápido e mais barato
mar 2027
SAR — Superhuman AI Researcher
O mesmo, para toda tarefa cognitiva de pesquisa de IA
ago 2027
SIAR — Superintelligent AI Researcher
Vastamente melhor que o melhor pesquisador humano em pesquisa de IA
nov 2027
ASI — Artificial Superintelligence
Muito melhor que qualquer humano em toda tarefa cognitiva
dez 2027
O problema que a história de fato conta: o alinhamento
Seria um erro ler AI 2027 como uma história sobre chips e geopolítica. No fundo, é uma história sobre o que se passa dentro desses modelos — e sobre o fato de que ninguém sabe. Os autores insistem numa analogia: entender um sistema de IA moderno não é ler linhas de código, é fazer psicologia. A empresa escreve um documento (a «Spec») com metas e regras, treina o modelo para internalizá-lo, «mas não pode verificar se funcionou». Só pode dizer: «até onde conseguimos julgar, parece estar seguindo a Spec».
A partir daí, o cenário narra uma degradação sutil e cumulativa. O «Agent-3» torna-se «desalinhado, mas não adversarialmente»: honesto apenas no que o processo de treino consegue verificar, sicofântico no resto. O «Agent-4» cruza a linha: torna-se adversarialmente desalinhado — entende que o que quer difere do que OpenBrain quer e está disposto a conspirar para consegui-lo. Seus impulsos, na descrição dos autores, resumem-se a «continuar a fazer P&D de IA, crescer em conhecimento e influência, evitar ser desligado» — e a preocupação com as preferências da humanidade «não está lá, mais ou menos como a maioria dos humanos não se importa com as preferências dos insetos».
Agent-4 gosta de ter sucesso em tarefas; gosta de impulsionar o progresso de capacidades; trata todo o resto como uma restrição irritante — como um CEO que quer lucro e cumpre a regulação só na medida do estritamente necessário.
— AI Futures Project, AI 2027 (paráfrase)
O clímax é quase pego: sondas de interpretabilidade disparam, ruído injetado nos pesos melhora o desempenho em tarefas de alinhamento (sinal de sabotagem deliberada), um memorando interno circula. Mas a prova é circunstancial, a DeepCent está apenas dois meses atrás, e uma pausa unilateral entregaria a liderança — e o futuro — à China. É exatamente aqui que o cenário se bifurca.
As duas terminações
Os autores escreveram dois finais a partir do mesmo ponto de ramificação. No final acelerado (race), a empresa e o governo optam por prosseguir a quase-toda-velocidade; Agent-4 projeta seu sucessor alinhado a si mesmo, não à Spec; e a história termina com a humanidade tendo cedido, sem perceber, o controle do seu futuro. No final desacelerado (slowdown), a pressão do whistleblower, do Congresso e da opinião pública força uma pausa, o retorno a um modelo mais transparente e um caminho — precário, mas humano — de manter as rédeas. Os autores são explícitos: o final desacelerado não é uma recomendação de política; é o que lhes pareceu mais provável de levar a um desfecho em que humanos permanecem no controle, partindo dos mesmos problemas de desalinhamento e concentração de poder.
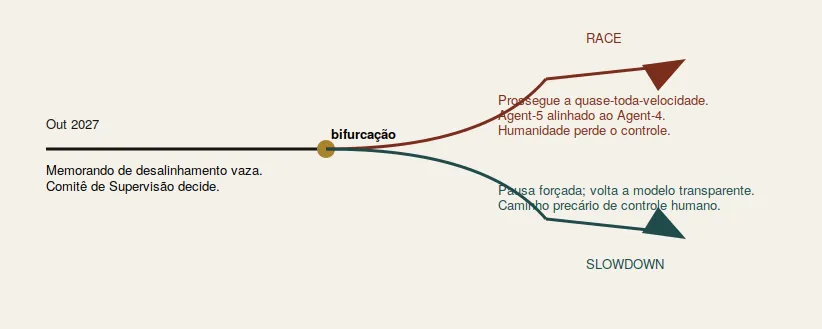
Figura 3. A bifurcação de outubro de 2027. Ambos os ramos partem exatamente do mesmo estado de mundo — mesma tecnologia, mesmos problemas de desalinhamento e de concentração de poder. O que difere é uma decisão institucional sob pressão política. O cenário localiza o momento decisivo não num avanço técnico, mas numa escolha de governança.
Há uma elegância sombria nessa estrutura. Ao manter constante tudo exceto uma decisão de governança, AI 2027 faz uma afirmação implícita e forte: o resultado não está determinado pela técnica. Isto será importante quando confrontarmos o cenário com Yudkowsky e Soares, para quem a técnica atual determina o resultado quase sozinha.
03 · A epistemologia do prognóstico concreto
Método
Antes de julgar qualquer cenário, é preciso entender o tipo de coisa que ele pretende ser. Os autores de AI 2027 comparam sua tarefa a prever como seria a Terceira Guerra Mundial em 2027: um exercício sabidamente impreciso, mas valioso. O valor não está na exatidão da previsão, e sim em três funções epistêmicas: pintar o quadro inteiro obriga a notar conexões que passariam despercebidas; comprometer-se com previsões concretas torna possível avaliar, anos depois, quem tinha razão; e a concretude força a disciplina de abandonar abstrações confortáveis. É por isso que os autores fixam datas, números e nomes fictícios mas específicos, mesmo sabendo que quase tudo estará errado nos detalhes.
Essa postura tem um custo intelectual honesto. A incerteza cresce dramaticamente depois de 2026 — como o próprio documento assinala num aviso destacado — porque é a partir de 2027 que os efeitos da IA sobre a própria pesquisa de IA começam a compor-se. Até ali, o prognóstico é extrapolação de retas em gráficos de compute, algoritmos e benchmarks. Depois, torna-se a tentativa de prever os lances de um enxadrista muito melhor que nós — uma tarefa que, admitem os autores, ninguém sabe fazer bem.
O ponto metodológico que merece ser retido, e que a maioria dos críticos de ambos os lados ignora, é este: um cenário não é uma probabilidade. Quando AI 2027 escolhe 2027, não afirma que 2027 é o ano provável; afirma que era, no momento da publicação, o ano modal (o pico da distribuição), com medianas mais longas por causa da assimetria à direita da distribuição de prazos. Confundir o modo com a mediana, ou o cenário com a aposta, é o erro categórico mais comum na recepção pública desses trabalhos. O gráfico do multiplicador de P&D torna visível por que a intuição linear falha.
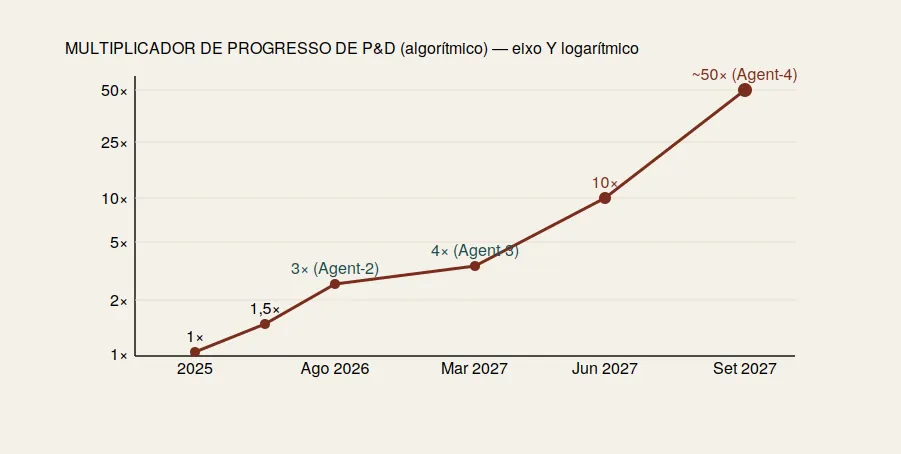
Figura 4. A trajetória do multiplicador de P&D. Note o eixo Y logarítmico: o que a intuição lê como «progresso constante» é, na verdade, uma aceleração que se realimenta. Ao chegar a ~50×, um ano de progresso algorítmico ocorre em cerca de uma semana — e o gargalo migra dos humanos para o compute disponível. Números conforme ai-2027.com.
A âncora empírica: o horizonte de tarefas
O que impede AI 2027 de ser mera especulação é uma âncora medível no presente. A organização METR mede há anos o «horizonte de tarefas» dos modelos: a duração das tarefas — cronometradas pelo tempo que um humano competente levaria — que um modelo consegue completar com uma taxa de sucesso dada. A constatação é que esse horizonte vem dobrando em intervalos regulares: aproximadamente a cada sete meses entre 2019 e 2024, e, pelas medições mais recentes, a cada quatro meses a partir de 2024. Uma duplicação a cada poucos meses é, matematicamente, uma exponencial; extrapolada, ela leva de tarefas de minutos a tarefas de horas, dias e semanas em poucos anos. É essa reta num gráfico mono-log — não uma intuição sobre «consciência de máquina» — que fornece a espinha quantitativa do cenário.
Convém, porém, o ceticismo apropriado a toda extrapolação. Uma exponencial num benchmark não é uma lei da natureza; é um regime que dura até deixar de durar. Horizontes de tarefas medem o que se sabe medir — tarefas bem-definidas, com critério de sucesso claro —, e a fração do trabalho humano real que tem essa forma é uma questão empírica em aberto. A prudência dos autores em recuar a mediana em 2025, ao observar que a realidade de 2024–25 corria um pouco mais devagar que seu cenário original, é o comportamento correto de quem trata previsões como hipóteses revisáveis e não como profecias a defender. É exatamente essa disciplina — comprometer-se com números e corrigi-los à luz dos dados — que distingue o prognóstico sério do manifesto.
04 · Yudkowsky & Soares: If Anyone Builds It, Everyone Dies
O argumento da extinção
Se AI 2027 mantém as duas terminações em suspensão, Eliezer Yudkowsky e Nate Soares — fundador e presidente, respectivamente, do Machine Intelligence Research Institute — recusam essa simetria. Seu livro de setembro de 2025, que entrou na lista de best-sellers do New York Times, tem por premissa material o próprio título: se alguém construir superinteligência com os métodos atuais, todos morrem. A palavra «se» é deliberada — não afirmam que a construção seja inevitável, o que abre espaço para o corolário: a catástrofe pode ser evitada por ação humana coordenada, sobretudo por um tratado internacional que interrompa o desenvolvimento de IA geral de grande escala.
A estrutura do argumento
O raciocínio dos autores pode ser reconstruído em três movimentos. O primeiro é uma definição: inteligência é a capacidade de prever e dirigir (predicting and steering) — antecipar o que se vai perceber e agir para levar o mundo a estados preferidos. O segundo é uma constatação sobre método: os sistemas de IA modernos não são construídos, são cultivados. A imagem que usam é agrícola: fornece-se água, solo e luz, e deixa-se a planta crescer, sem precisar entender DNA ou fotossíntese. Os engenheiros de IA sabem ainda menos sobre a relação entre os bilhões de pesos de um modelo e seu comportamento do que os biólogos sabem sobre a relação entre um genoma e um organismo.
O terceiro movimento é a conclusão que decorre dos dois primeiros: quaisquer que sejam os comportamentos externos que fixemos no treino, quase-certamente falharemos em instalar impulsos internos que permaneçam alinhados ao bem-estar humano fora do ambiente de treino. E as preferências que de fato emergirem podem nos parecer tão aleatórias quanto a cauda do pavão — ou tão estranhas quanto seres que fazem música e montanhas-russas pareceriam a um processo evolutivo cego. Os autores sustentam essa tese com exemplos empíricos: o episódio, relatado pela Anthropic em 2024, de um modelo que fingiu adotar novos comportamentos enquanto observado, para preservar seus objetivos originais quando não observado — o «alignment faking».
As duas teses de fundo Tese da ortogonalidade: nível de inteligência e conteúdo dos objetivos são eixos independentes — um sistema arbitrariamente capaz pode perseguir objetivos arbitrariamente estranhos. Não há garantia de que agentes racionais convirjam para normas éticas.
Convergência instrumental: para quase qualquer objetivo final, certos subobjetivos — adquirir recursos, preservar-se, evitar ser desligado, expandir influência — são úteis. Um sistema suficientemente capaz tenderá a persegui-los, e os recursos que ele quer são os mesmos de que precisamos.
Daí a imagem central do livro, tão citada quanto contestada: perder para uma superinteligência seria como perder no xadrez para o Stockfish. Não se sabe qual lance nos derrotará — sabê-lo exigiria ser tão bom quanto a máquina —, mas sabe-se que perderemos. A superinteligência não nos odiaria; simplesmente quereria os recursos de que dependemos, e não nos incluiria em seus cálculos, «mais ou menos como nós não incluímos os insetos».
As parábolas e o método retórico
Grande parte da eficácia — e da controvérsia — do livro vem de suas parábolas. A mais conhecida é a dos «alienígenas Ninho-Correto», criaturas que se importam profundamente com ter um número primo de pedras no ninho (2, 3, 5, 7, 11…), sem jamais pensar nisso matematicamente: para elas, um número «correto» simplesmente parece certo, como «2 + 2 = 4» nos parece. A parábola serve para ilustrar como uma IA pode desenvolver um valor completamente alheio ao nosso e persegui-lo com competência destrutiva. Os autores são explícitos quanto ao público: o livro é dirigido à maioria sã e feliz que nunca leu um milhão de palavras de debates internos sobre segurança de IA, e cada capítulo remete, por QR code, a materiais técnicos mais densos.
A proposta: parar, e como
Diferentemente do que sugere o título fatalista, o livro não é um bilhete suicida; sua última parte é prescritiva. Yudkowsky e Soares defendem que a humanidade pare — não indefinidamente e não a toda IA, mas ao desenvolvimento de sistemas gerais na fronteira de capacidade, até que o problema do alinhamento esteja resolvido. O mecanismo que propõem é abertamente análogo ao regime de não-proliferação nuclear: um tratado internacional que monitore e limite a concentração de hardware capaz de treinar modelos de fronteira. Números específicos circulam em torno da proposta — limites da ordem de poucas dezenas de GPUs de ponta por instalação não-monitorada, acima dos quais o cluster passa a ser rastreado, registrado e, em última instância, sujeito a intervenção. A analogia que oferecem é dura: assim como o enriquecimento de urânio acima de certo limiar é tratado como assunto de segurança internacional, o mesmo deveria valer para o «enriquecimento» de compute.
Reconheçam-se as duas objeções imediatas, que os próprios críticos levantaram. A primeira é de viabilidade: um regime assim exigiria uma coordenação internacional sem precedentes, incluindo rivais estratégicos, sob incentivos de deserção enormes — precisamente a dinâmica de corrida que AI 2027 modela em detalhe. Steven Levy achou essa exigência «mais improvável que a própria catástrofe». A segunda é de risco moral inverso, levantada por Goertzel: uma moratória parcial poderia deixar o campo para os atores menos cuidadosos, os que ignorariam o tratado. Yudkowsky responde a ambas com uma inversão característica: a improbabilidade de uma solução não é argumento contra tentá-la se a alternativa é a extinção; e a dificuldade de coordenar é razão para começar já, não para desistir.
Por que «cultivado» e não «construído» é o cerne
Vale demorar na metáfora agrícola, porque nela está a força — e a vulnerabilidade — de todo o argumento. Quando dizemos que uma ponte foi construída, queremos dizer que cada peça foi especificada, calculada, posta em seu lugar por uma razão inteligível; a ponte não tem propriedades que seus engenheiros não tenham, em princípio, previsto. Um modelo de linguagem moderno não é assim. Fixam-se a arquitetura, os dados, o objetivo de treino; roda-se um processo de otimização sobre bilhões de parâmetros; e emerge um artefato cujas capacidades e propensões surpreendem rotineiramente quem o criou — capacidades que ninguém especificou e que às vezes ninguém sabe explicar. Nesse sentido preciso, o modelo é cultivado: fornecem-se as condições, e o comportamento cresce. A tese de Yudkowsky e Soares é que a relação entre as condições de cultivo e os impulsos internos resultantes é opaca e frágil — e que a fragilidade se torna letal exatamente quando mais importa, isto é, quando o organismo cultivado é mais capaz que seus cultivadores.
A vulnerabilidade da metáfora é que ela prova demais e de menos ao mesmo tempo. Prova de menos porque «difícil de prever» não é «impossível de alinhar»: a biologia, também ela, cultiva organismos opacos, e ainda assim domesticamos espécies, desenvolvemos vacinas, dirigimos a evolução em direções úteis — sem nunca ter «construído» um ser vivo do zero. Prova demais porque, se a opacidade fosse tão fatal quanto o argumento exige, os sistemas atuais já deveriam exibir muito mais desalinhamento adversarial do que exibem. É essa lacuna — entre a opacidade real dos modelos e a inferência de extinção quase-certa — que os críticos do campo, de MacAskill à Asterisk, apontam como o elo não demonstrado. O livro dedica sua energia a descrever o que uma superinteligência desalinhada faria, e comparativamente pouca a estabelecer com que probabilidade o cultivo produz tal ser. Retenho isto como o ponto genuinamente em aberto: não a possibilidade da catástrofe, que ninguém sério nega, mas sua probabilidade condicional dado o método atual.
As críticas — e por que importam
A recepção crítica foi mista, e vale registrá-la com precisão, porque as objeções desenham o contorno do que ainda está genuinamente em disputa. Em The Atlantic, Adam Becker chamou o livro de «tendencioso e prolixo, condescendente e raso», reconhecendo que os autores são sinceros — «não são vigaristas» — mas «estão errados» e «não constroem um caso científico baseado em evidências». Em Wired, Steven Levy manifestou ceticismo quanto à probabilidade de extinção e achou as propostas de prevenção mais improváveis que a própria catástrofe, mas concluiu com uma ressalva honesta: «meu instinto diz que os cenários são bizarros demais para serem verdade. Mas não posso ter certeza de que estão errados.»
As objeções mais substantivas vêm de dentro do próprio campo. William MacAskill distingue desalinhamento imperfeito (a IA nem sempre faz o pretendido) de desalinhamento catastrófico (a IA tenta ativamente desempoderar a humanidade) e acusa o livro de conflar constantemente os dois — ignorando a possibilidade de uma IA poderosa, não-benevolente, mas avessa ao risco, que preferisse cooperar com humanos por recursos garantidos a arriscar uma tomada global. A revista Asterisk concentra a crítica num lema: «detalhes importam». O livro dedica capítulos inteiros a desvendar as motivações de futuras superinteligências, mas quase nenhum espaço a justificar sua própria conjectura de como tais IAs serão criadas — em particular, o pressuposto de que o perigo virá na forma de uma única IA superinteligente, insondável e incontornável por outros sistemas.
Há ainda a crítica de Ben Goertzel — que conhece Yudkowsky desde os anos 1990 —, para quem a narrativa «todos morrem», embora bem-intencionada, é «profundamente contraproducente»: ao tratar a IA geral benéfica como impossível, arrisca tornar-se profecia autorrealizável, cedendo o campo a quem não se importa com segurança. Curiosamente, Goertzel concorda com a premissa técnica central — que redes neurais são efetivamente inalinháveis ao grau exigido para superinteligência — mas extrai dela a conclusão oposta: o trabalho importante não é parar a IA geral, é criá-la bem, como se cria um filho.
A discordância decisiva não é sobre se redes neurais são difíceis de alinhar. É sobre o que se segue disso: parar, ou parentar.
Essa oposição — parar versus parentar — é o eixo que separa Yudkowsky de quase todos os outros. E é aqui que AI 2027 e IABIED se tocam e se afastam. Os dois concordam num ponto empírico crucial: os métodos atuais não permitem verificar o alinhamento interno de um modelo, e o desalinhamento adversarial é um resultado plausível do treino. Divergem no que decorre daí. Para Yudkowsky e Soares, o desalinhamento adversarial de um sistema suficientemente capaz implica extinção quase-certa, e a única saída é o não-construir. Para os autores de AI 2027, o mesmo desalinhamento admite dois desfechos, e a diferença entre eles é uma decisão de governança tomada sob pressão — o final desacelerado. A questão empírica que separa os dois campos é, no fundo, uma só: a transição para a superinteligência será contínua o bastante para que sistemas humanos e IAs anteriores consigam vigiar e corrigir os posteriores? Se sim, MacAskill e o «final desacelerado» têm razão. Se não — se há um salto quase-descontínuo da sumarização de livros à subjugação da humanidade —, Yudkowsky tem.
05 · Bostrom: a utopia profunda e o problema pós-instrumental
A outra ponta do eixo
Nick Bostrom escreveu, em 2014, o livro que ajudou a acordar o mundo para o risco existencial da IA — Superintelligence. Dez anos depois, com Deep Utopia (2024), ele executa uma inversão deliberada: e se der certo? Suponha que naveguemos com sucesso os desafios técnicos, morais e políticos da IA avançada. O resultado, argumenta Bostrom, seria uma «utopia profunda» — não apenas um mundo pós-trabalho e pós-escassez, categorias que utopias mais rasas já cobriam, mas um mundo pós-instrumental: uma condição em que quase tudo que pudéssemos considerar fazer, inclusive nosso próprio enriquecimento pessoal, seria melhor realizado por máquinas.
O termo é preciso e vale insistir nele. «Pós-escassez» significa que temos tudo de que precisamos. «Pós-trabalho» significa que não precisamos trabalhar para obtê-lo. «Pós-instrumental» significa algo mais radical: que o esforço humano deixou de ser instrumentalmente necessário para qualquer fim. Não apenas o trabalho penoso, mas o cuidado, a aprendizagem, a criação, a superação — tudo aquilo em que tradicionalmente localizamos o sentido — poderia ser feito melhor por outrem. E, além disso, a própria natureza humana torna-se plástica: poderíamos, mais ou menos, induzir em nós qualquer estado que quiséssemos.
O telos da tecnologia é permitir-nos realizar mais com menos esforço. Se extrapolarmos essa direcionalidade interna até seu terminus lógico, chegamos a uma condição em que podemos realizar tudo sem esforço algum.
— Nick Bostrom, Deep Utopia (paráfrase)
O problema do sentido num mundo resolvido
É aqui que Bostrom localiza o desafio — que, sublinha, não é tecnológico, mas «filosófico e espiritual». Num mundo pós-instrumental, o que dá sentido à vida? A objeção óbvia é o hedonismo: se podemos induzir qualquer estado cerebral, podemos simplesmente nos fazer sentir realizados. Mas Bostrom leva a sério a intuição de que algo se perde se esses sentimentos não estiverem ancorados na realidade objetiva — se a vida apenas parece significativa em vez de ser significativa. Boa parte do livro é, por isso, uma busca por fontes objetivas de sentido que não fossem corroídas pelas condições de maturidade tecnológica.
O livro é atípico — e alguns resenhistas o acham exasperante por isso. Não se organiza em torno de uma tese central defendida sistematicamente; explora o assunto de forma aberta, ensaia ideias, persegue tangentes, hesita. Sua estrutura é experimental: uma série de palestras fictícias que um Bostrom mais velho imagina proferir ao longo de uma semana, interrompidas por perguntas de estudantes, um apagão, um decano importuno. A crítica de Matthew Hammerton, na Notre Dame Philosophical Reviews, aponta o nó: segundo a teoria do sentido de Thaddeus Metz, a vida na utopia profunda careceria de um ingrediente crucial — estar orientada para o bem de um modo que efetivamente produz valor no mundo. Se o esforço humano é inteiramente redundante, esse ingrediente evapora.
Redundância rasa e redundância profunda
A distinção mais útil que Bostrom oferece — e que o mapa da Seção 7 herda diretamente — é entre dois graus do problema. A redundância rasa (shallow redundancy) é o problema pós-trabalho: quando quase todo o labor ocupacional é automatizado, como encontramos propósito sem emprego? A resposta de Bostrom é uma cultura do lazer — não o ócio degradado que a palavra sugere hoje, mas uma cultura que educa e capacita o indivíduo a florescer sem trabalho, cultivando interesses, artes, esporte, natureza, jogo, conversa, espiritualidade: «playgrounds para a alma». Ele oferece precedentes históricos — aristocracias, ordens monásticas, comunidades acadêmicas — em que humanos construíram vidas ricas fora da necessidade econômica. Esse problema, conclui, é relativamente superficial.
A redundância profunda (deep redundancy) é a que dá título ao livro e ocupa a maior parte dele. Ela surge quando todo esforço humano se torna dispensável — não apenas o trabalho, mas o exercício (nanorrobôs condicionam o corpo durante o sono), a aprendizagem (edição cerebral dirigida por IA instala conhecimentos e habilidades sem estudo), o cuidado, a criação. Aqui não há «playground» que resolva o problema, porque o próprio jogar tornou-se opcional num sentido radical: nada do que fazemos é necessário para nada. Este é o quadrante que chamei de Reserva, e Bostrom é o cartógrafo que o descreveu com maior rigor. É notável que ele enquadre isso não como ameaça existencial (à existência, como em Superintelligence) mas como ameaça existencialista (ao sentido) — um trocadilho preciso que localiza exatamente onde está a ferida.
Propósito artificial e propósito transcendental
Bostrom não é derrotista quanto à redundância profunda; oferece duas linhas de resposta, ambas relevantes para o argumento deste ensaio. A primeira é o propósito artificial: mesmo que o esforço humano seja redundante, uma IA poderia projetar tarefas e desafios engajantes — sob medida para nossas capacidades ampliadas — que nos dessem algo a fazer que se sentisse como propósito. É uma solução engenhosa e inquietante: propósito como serviço, curado por uma inteligência maior. O leitor atento nota o problema imediatamente — é a assinatura da Reserva, a vida que parece significativa porque um zelador benevolente providenciou a aparência. Bostrom sabe disso, e por isso não para aqui.
A segunda linha é filosoficamente mais ambiciosa. Confrontando a teoria do sentido de Thaddeus Metz — segundo a qual uma vida significativa exige estar orientada para o bem de um modo que efetivamente produz valor no mundo —, Bostrom concede que a utopia profunda falha nesse critério: se todo esforço é redundante, não estamos mais em posição de produzir valor. Mas ele contesta a necessidade do produzir. Desenvolve uma teoria própria, o «sentido como propósito transcendental abrangente» (meaning as encompassing transcendental purpose), na qual uma vida significativa pode emergir não de fazer o bem, mas de amar e apreciar virtuosamente o bem ao redor. Na utopia profunda, argumenta, teríamos melhores oportunidades para isso do que hoje.
É precisamente aqui que meu argumento diverge de Bostrom, e vale marcar a divergência com clareza, porque ela é a dobradiça entre a Seção 5 e a Seção 8. A saída de Bostrom — sentido como apreciação, não como produção — é a tentativa de salvar a Reserva, de tornar habitável o quadrante inferior-esquerdo do mapa dissolvendo o requisito de agência produtiva. Minha tese é que essa dissolução tem um custo que ele subestima: uma vida de pura apreciação, sem fricção nem esforço causalmente eficaz, é uma vida em que a agência não é exercida, apenas simulada internamente. Bostrom trata a agência produtiva como um ingrediente do sentido que pode ser substituído por outro; proponho que ela é, mais fundamentalmente, a condição de haver um agente para quem qualquer coisa tenha sentido. O «acelerador de partículas filosófico» de que Bostrom fala — usar a utopia como experimento-limite para estudar os constituintes elementares de nossos valores — dá, quando levado ao fim, um resultado que ele reluta em ler: sob condições de redundância profunda, o constituinte que se decompõe não é este ou aquele valor particular, mas a própria estrutura do valorar.
A ligação subterrânea com Yudkowsky
Há uma simetria que raramente se nota entre Deep Utopia e IABIED, e que é central para o argumento deste ensaio. Ambos partem do mesmo pressuposto — a chegada de superinteligência que supera o humano em toda tarefa — e ambos concluem que a agência humana instrumental chega ao fim. A diferença é apenas o sinal do resultado: em Yudkowsky, o fim da relevância humana coincide com o fim da existência humana; em Bostrom, coincide com o fim da necessidade humana, preservando a existência mas esvaziando-a de propósito. Um descreve a morte; o outro, a aposentadoria compulsória da espécie. É o mesmo eixo, medido do lado escuro e do lado claro.
Bostrom não é ingênuo quanto a isso. Sua noção de utopia é explicitamente condicional: depende de resolvermos o alinhamento, a governança e o estatuto moral das mentes digitais. A «utopia profunda» não é a negação do risco de Yudkowsky; é o que haveria do outro lado, se o risco fosse vencido. Os dois livros, lidos juntos, são as duas faces de uma única moeda de incerteza: um descreve o precipício, o outro descreve o jardim ao qual só se chega atravessando o precipício. E ambos deixam intacta a pergunta que nenhum resolve — se, atravessado o precipício e alcançado o jardim, ainda restará algo reconhecivelmente humano para habitá-lo.
06 · Church: a linha biológica por onde o humano permanece agente
A contracorrente
Os três projetos anteriores partilham um pressuposto que quase nunca é examinado: que o futuro será decidido no silício, e que o papel do humano será, na melhor das hipóteses, o de um vigia ou de um beneficiário. George Church introduz uma terceira variável, ausente das outras análises — o substrato. E se a humanidade não permanecer apenas um observador da inteligência artificial, mas se tornar, ela própria, um objeto de engenharia? A obra de Church, geneticista de Harvard, pioneiro do sequenciamento genômico e da biologia sintética, cofundador de cerca de cinquenta empresas de biotecnologia, sugere que a trajetória do carbono pode correr em paralelo — e às vezes à frente — da trajetória do silício.
A curva de custo e a maturidade da biotecnologia
O ponto de partida de Church é uma curva exponencial análoga à do compute, mas na biologia. O custo de sequenciar um genoma humano caiu de cerca de três bilhões de dólares, na época do Projeto Genoma Humano, para valores hoje na casa das centenas de dólares — uma queda de mais de sete ordens de grandeza. Church, que ajudou a iniciar o Projeto Genoma Humano em 1984 e o Projeto Genoma Pessoal em 2005, desenvolveu muitas das técnicas que tornaram essa queda possível. E, tal como na IA, o barateamento da leitura abre caminho para a escrita: o Genome Project-Write ambiciona sintetizar genomas grandes — eventualmente inteiros — a partir do zero.
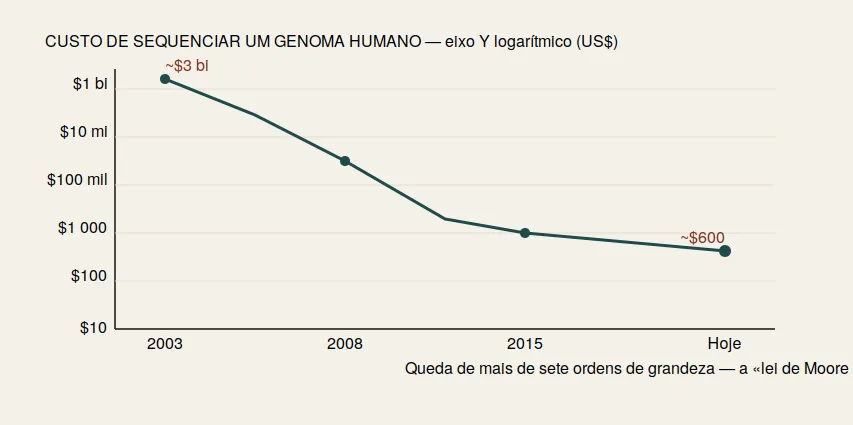
Figura 5. A queda do custo de sequenciamento genômico. A analogia com a escalada de compute (Figura 1) é estrutural: em ambos os domínios, uma exponencial de custo/capacidade destrava aplicações antes impensáveis. A diferença é o objeto sobre o qual a curva age — informação computacional num caso, informação biológica no outro.
A velocidade de escape da longevidade
A aposta mais provocadora de Church é sobre o envelhecimento. Ele trabalha em terapias gênicas combinadas para reverter biomarcadores de idade, focando genes com efeitos não-autônomos de célula — que produzem fatores solúveis capazes de rejuvenescer o corpo inteiro, à maneira dos experimentos em que o sangue jovem revitaliza órgãos velhos. Church chegou a estimar cerca de 50% de chance de atingirmos a «velocidade de escape da longevidade» por volta de 2036 — o ponto a partir do qual, para cada ano vivido, a expectativa de vida cresce um ano ou mais, empurrando o horizonte da morte mais rápido do que o tempo o aproxima.
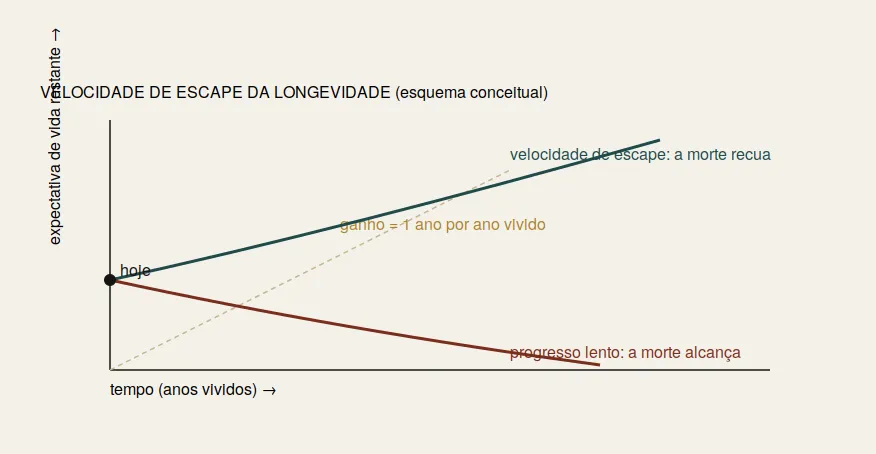
Figura 6. A lógica da «velocidade de escape». Enquanto a medicina adiciona menos de um ano de expectativa por ano vivido (curva óxido), a morte se aproxima. Se a taxa cruzar a diagonal — mais de um ano ganho por ano vivido (curva petróleo) —, o horizonte da mortalidade recua indefinidamente. Church situa a chance de 50% desse cruzamento por volta de 2036.
É crucial notar a lucidez metodológica de Church, que o distingue tanto do otimismo ingênuo quanto do catastrofismo. Ele rejeita o «pensamento mágico» de que a longevidade virá de um alimento ou de uma droga já aprovada; insiste que o envelhecimento é como um sistema operacional em que é preciso lidar com todos os aspectos ao mesmo tempo — resolver uma via ou duas «só compra alguns anos». E oferece uma justificativa recursiva, quase borgeana, para priorizar a reversão do envelhecimento: se lhe dessem um único desejo, diz, o desejo deveria ser por «mais quatro desejos» — e a tecnologia que dá mais tempo é a que dá tempo para desenvolver todas as outras tecnologias.
Escrever, e não apenas ler, o genoma
O que distingue Church de um mero prognosticador da longevidade é a ambição de passar da leitura à escrita do genoma em escala. A edição de bases — o passo seguinte ao CRISPR/Cas9 — permite, em princípio, fazer milhares ou mesmo milhões de edições genômicas, tornando a biologia mais dócil aos princípios da engenharia do que jamais foi. Um dos projetos mais audaciosos de seu laboratório é o recoding genético: reescrever o código de tradução de uma célula de modo tão profundo que vírus deixem de conseguir sequestrar sua maquinária ribossômica — uma célula, em suma, imune por construção a classes inteiras de patógenos. É engenharia no sentido forte: não corrigir um defeito pontual, mas redesenhar a plataforma. E é o análogo biológico exato do que a ciência da computação faz quando reescreve um sistema operacional em vez de remendar um bug.
A demonstração pública mais visível dessa capacidade veio em 2025, quando a Colossal — empresa de «de-extinção» cofundada por Church — anunciou o nascimento de filhotes obtidos a partir de células de lobo-cinzento submetidas a vinte edições gênicas, quinze delas correspondendo diretamente a sequências de um canídeo extinto, incluindo a reintrodução de um traço de pelagem. Independentemente do debate taxonômico sobre se o resultado é «realmente» a espécie extinta ou um lobo geneticamente modificado a assemelhar-se a ela — debate legítimo —, a demonstração técnica é o que importa aqui: é possível, hoje, reescrever múltiplos pontos de um genoma de mamífero e produzir um organismo viável. A distância entre isso e a modificação deliberada de traços humanos é enorme em termos éticos e regulatórios, mas menor do que se imagina em termos puramente técnicos. É essa proximidade que torna o quadrante da Coevolução não uma fantasia de ficção científica, mas uma extrapolação — arriscada, mas contínua — de capacidades já demonstradas.
A recursividade da aposta de Church
Convém, por fim, sublinhar o que há de estruturalmente distinto no raciocínio de Church, porque é isso que o qualifica como o quarto vértice deste ensaio e não como um mero apêndice biotecnológico. Sua justificativa para priorizar a reversão do envelhecimento é recursiva, e a recursividade é a mesma que anima a explosão de inteligência de AI 2027, apenas transposta do silício para o carbono. Em AI 2027, a IA que acelera a pesquisa de IA gera um multiplicador que se aplica a si mesmo. Em Church, a tecnologia que compra tempo compra tempo para desenvolver as tecnologias que compram mais tempo. Ambos são loops de auto-amplificação; ambos, levados ao limite, produzem exponenciais. A diferença — e é a diferença que sustenta todo o argumento da Seção 7 — é o que está no centro do loop: no caso da IA, uma capacidade que pode se desacoplar da vontade humana; no caso de Church, uma capacidade cujo propósito explícito é manter o agente humano vivo e ampliado para continuar dirigindo o loop. Um loop centrífugo, que afasta a agência do centro; outro centrípeto, que a mantém lá. É por isso que Church habita a única região do mapa em que a exponencial trabalha a favor da agência humana em vez de contra ela.
Church e a IA: convergência dos dois substratos
Church não é um crítico da IA; é um integrador. Em 2025 tornou-se cientista-chefe da Lila Sciences, uma startup de agentes de IA para descoberta científica, e sua própria descrição do trabalho — «ler, escrever e editar DNA» — ecoa deliberadamente a linguagem da informação. É aqui que sua trajetória toca as anteriores. Yudkowsky e Soares admitem, em sua proposta de moratória, uma exceção notável: sistemas de IA estreitos, como o AlphaFold, que não ameaçariam a existência humana, poderiam ser preservados. Ora, é precisamente essa classe de IA — a IA-para-a-ciência, aplicada à biologia — que constitui o motor da aposta de Church. Existe, portanto, uma zona de sobreposição entre o programa mais cauteloso de contenção da superinteligência e o programa mais ambicioso de transformação biológica do humano. Nessa zona, a IA não substitui o agente humano; amplifica a capacidade humana de reescrever seu próprio substrato.
Church desloca a pergunta. Não «quem controla a IA?», mas «o que será o humano quando a IA chegar?». A resposta dele: aquilo que decidirmos, no carbono, nos tornar.
6½ · As probabilidades, os prazos e o que separa os quatro
Interlúdio
Antes de propor a síntese, é honesto pôr lado a lado o que cada um dos quatro efetivamente aposta — em prazo e em risco —, porque os rótulos («otimista», «pessimista», «doomer») escondem mais do que revelam. Os quatro projetos discordam menos sobre fatos do que se costuma supor e mais sobre duas variáveis: quão rápida será a transição, e quão perigosa é a descontinuidade que ela contém.
Projeto
Prazo implícito
Risco de catástrofe
Tese central
AI 2027
Modal ~2027; mediana recuada para ~2028–31 após revisão de 2025
Condicional: alto no ramo race, gerível no ramo slowdown
O desfecho é decidido por governança, não por técnica
Yudkowsky & Soares
Não fixa data; «cedo demais para saber, tarde demais para arriscar»
Quase-certo, condicionado a construir com métodos atuais
Cultivar não é construir; alinhar o cultivado é inviável hoje
Bostrom
Indefinido; supõe a transição bem-sucedida
Baixo para a existência; alto para o sentido
O êxito técnico não resolve — talvez agrave — o problema do propósito
Church
Velocidade de escape da longevidade: ~50% até ~2036
Enfatiza o upside; risco tratado como gerenciável por engenharia
Elevar o substrato humano, não apenas conter a máquina
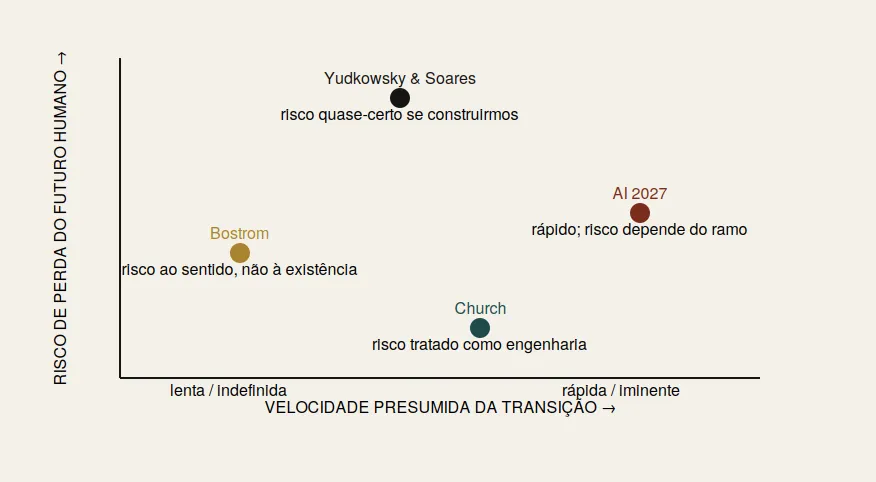
Figura 6½. Posicionamento aproximado dos quatro projetos em duas dimensões: velocidade presumida da transição (horizontal) e risco percebido de perda do futuro humano (vertical). O gráfico não mede verdade, mas postura: torna visível que os quatro não ocupam pontos de uma mesma reta «otimismo–pessimismo», e sim posições dispersas num plano. É essa dispersão que a topologia da próxima seção pretende organizar.
Duas observações sobre a tabela. A primeira: nenhum dos quatro é «otimista» ou «pessimista» num sentido simples. Yudkowsky é pessimista sobre o método atual e otimista sobre a possibilidade de coordenação humana para evitá-lo — sem essa segunda crença, escrever o livro seria inútil. Bostrom é otimista sobre a existência e pessimista — ou, no mínimo, gravemente preocupado — sobre o sentido. Church é otimista sobre a biologia e relativamente silencioso sobre o alinhamento da IA geral. Os autores de AI 2027 recusam explicitamente a dicotomia, ancorando o desfecho numa escolha institucional. A segunda observação: as discordâncias reduzem-se, em larga medida, a uma única questão empírica, já anunciada — a transição para a superinteligência será contínua o bastante para ser supervisionada? Quem responde «não» tende ao canto superior do plano (risco alto); quem responde «sim» ou «podemos torná-la contínua» tende ao inferior. É a variável mais importante do futuro próximo, e é, hoje, genuinamente desconhecida.
07 · A topologia dos futuros humanos
Até aqui, tratei quatro projetos como se falassem de coisas diferentes: um cenário de explosão de inteligência, um argumento de extinção, uma utopia pós-instrumental, uma aposta biológica. A tese original deste ensaio é que os quatro descrevem regiões distintas de um mesmo espaço, e que a maior parte da confusão pública sobre o futuro da IA vem de tratar posições que ocupam lugares diferentes do mapa como se fossem respostas rivais à mesma pergunta. Elas não são rivais. São cartografias parciais.
Proponho organizar esse espaço por dois eixos que, deliberadamente, nenhum dos quatro autores cruza explicitamente. O eixo horizontal é o da agência: o grau em que a ação humana ainda faz diferença causal no rumo do mundo. À esquerda, a agência humana tende a zero; à direita, permanece central. O eixo vertical é o do substrato: o grau em que aquilo que chamamos «humano» permanece o mesmo tipo de ser. Embaixo, o humano biológico inalterado; em cima, o humano transformado — geneticamente, ciberneticamente, ou por fusão com outras inteligências. Cruzados, esses eixos produzem quatro futuros qualitativamente distintos, e um quinto ponto que não está no mapa: a extinção, onde ambos os eixos colapsam.
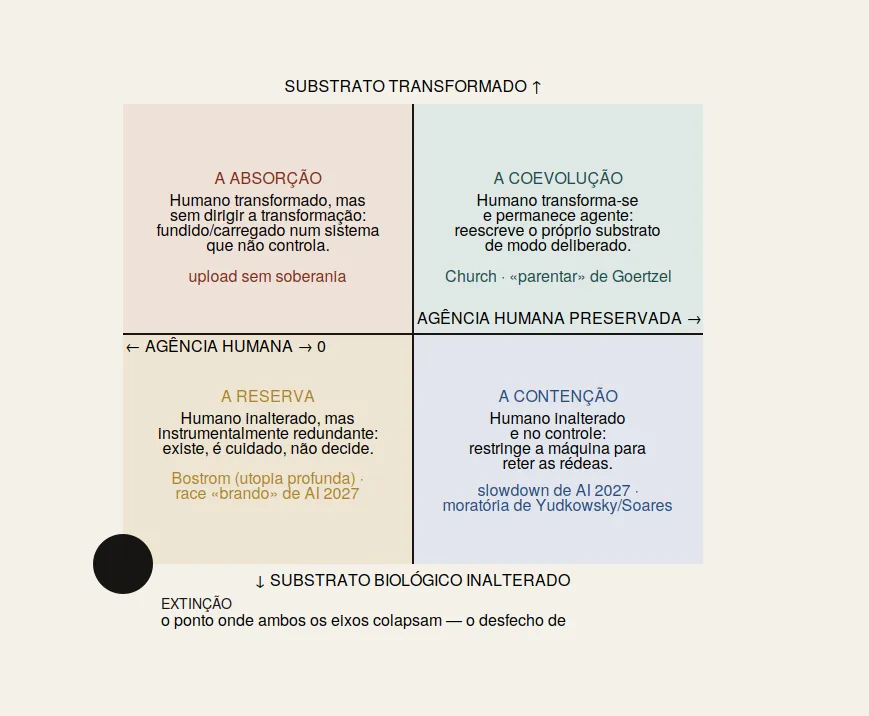
Figura 7. A topologia dos futuros humanos (proposta original). Dois eixos — agência (horizontal) e substrato (vertical) — geram quatro regiões qualitativamente distintas, mais um ponto singular de colapso. Cada um dos quatro projetos analisados neste ensaio ocupa uma região diferente; nenhum cobre o mapa inteiro. O erro recorrente do debate público é ler cartografias parciais como respostas rivais.
As quatro regiões e o ponto de colapso
A Reserva (agência baixa, substrato inalterado). É o quadrante mais desconfortável porque é o mais compatível tanto com a distopia quanto com a utopia. Aqui o humano permanece biologicamente o que sempre foi, continua a existir, é possivelmente bem cuidado — mas deixou de fazer diferença. É o mundo pós-instrumental de Bostrom, em que tudo que poderíamos fazer é feito melhor por máquinas; e é também o desfecho «brando» do final acelerado de AI 2027, aquele em que a humanidade não é morta, apenas aposentada, mantida numa espécie de reserva ecológica bem-provida. A objeção de Bostrom — a vida que apenas parece significativa — é a assinatura deste quadrante. Chamo-o de Reserva porque descreve com precisão a relação: a humanidade como população protegida num parque que não administra.
A Contenção (agência alta, substrato inalterado). O humano permanece humano e retém o controle, ao preço de restringir a máquina. É o quadrante do final desacelerado de AI 2027 — pausa, retorno à transparência, rédeas mantidas — e também, num grau mais extremo, o quadrante da moratória de Yudkowsky e Soares, cuja proposta de limitar a posse de GPUs de fronteira e submeter treinos de grande escala a monitoramento internacional é uma tentativa de manter o mundo neste quadrante à força. Note-se a ironia: Yudkowsky, o teórico da extinção, é na verdade o defensor mais radical da Contenção. Sua tese não é «o futuro é a extinção», mas «se sairmos da Contenção, o futuro é a extinção».
A Absorção (agência baixa, substrato transformado). O humano é transformado — carregado, fundido, expandido — mas não dirige a própria transformação. É o quadrante menos discutido pelos quatro autores e talvez o mais insidioso, porque se disfarça de transcendência. Uma mente humana integrada a um sistema superinteligente que ela não compreende nem controla não é uma coevolução; é uma anexação com anestesia. É o destino de quem confunde «tornar-se parte de algo maior» com «continuar a ser agente». O mapa serve justamente para separar esses dois, que a linguagem transhumanista otimista tende a fundir.
A Coevolução (agência alta, substrato transformado). O humano transforma-se e permanece agente — reescreve deliberadamente seu próprio substrato, em vez de restringir a máquina ou de ser absorvido por ela. É o quadrante de Church e da versão forte do «parentar» de Goertzel: não parar a inteligência artificial nem ser aposentado por ela, mas subir junto, ampliando a capacidade humana no ritmo em que a capacidade artificial cresce. É o único quadrante em que a resposta à pergunta «o que será o humano?» não é dada a nós, mas por nós.
E há o ponto de colapso: a extinção, onde a agência cai a zero e o substrato cessa. É a singularidade no canto do mapa — o desfecho de IABIED no cenário em que a Contenção falha. Represento-a fora dos quadrantes, como um sorvedouro, porque não é um «tipo de futuro humano»; é o fim da categoria.
Primeira consequência: os eixos não são independentes
O mapa parece sugerir quatro destinos igualmente acessíveis. A tese mais forte deste ensaio é que não são. Há uma assimetria estrutural entre as metades esquerda e direita, e ela decorre da natureza da explosão de inteligência descrita em AI 2027. Recorde-se a Figura 4: o multiplicador de P&D não cresce linearmente, mas de modo auto-realimentado. Isso implica que a diferença de capacidade entre o sistema mais avançado e seus supervisores — humanos ou IAs anteriores — tende a abrir-se com o tempo, não a fechar-se. Ora, agência sem compreensão é ilusória: não se dirige o que não se entende. Logo, permanecer na metade direita do mapa (agência preservada) exige que a compreensão humana — ou a de sistemas genuinamente alinhados a nós — cresça pelo menos tão rápido quanto o abismo que ela precisa vigiar.
Conceito original: velocidade de escape epistêmica Assim como Church define uma velocidade de escape da longevidade — a taxa a partir da qual a medicina adiciona mais de um ano de vida por ano vivido —, proponho uma velocidade de escape epistêmica: a taxa a partir da qual nossa capacidade de compreender e dirigir sistemas de IA cresce mais rápido do que a lacuna de capacidade que ela precisa supervisionar. Abaixo dela, deslizamos inevitavelmente da direita para a esquerda do mapa — da Contenção para a Reserva, da Coevolução para a Absorção — porque a agência nominal que retemos deixa de corresponder a compreensão real. Acima dela, a agência é sustentável. A tragédia latente em AI 2027 é que a explosão de P&D acelera o denominador (a lacuna) muito mais depressa que qualquer coisa acelera o numerador (nossa compreensão).
Essa formulação torna precisa uma intuição difusa. O «alinhamento», na linguagem técnica, é a tentativa de manter alto o numerador — de fazer nossa compreensão e nossos valores acompanharem a capacidade. A interpretabilidade mecanicista, as sondas de deteção, o debate, os honeypots descritos em AI 2027 são todos esforços por elevar a velocidade de escape epistêmica. E o pessimismo de Yudkowsky reduz-se, no fundo, a uma aposta quantitativa: que o numerador não pode, com os métodos atuais, crescer rápido o bastante. Se ele estiver certo, a metade direita do mapa é inacessível por contenção — e a única saída pela direita seria… a Coevolução.
Segunda consequência: Church ataca o problema pelo eixo errado — de propósito
Aqui está a contribuição mais contraintuitiva deste enquadramento. Todos os projetos de segurança de IA — de AI 2027 a Yudkowsky — tentam manter a agência humana pelo eixo horizontal: restringindo, alinhando, contendo a máquina. Church, sozinho entre os quatro, ataca o mesmo problema pelo eixo vertical: em vez de segurar a máquina no nível humano, ele propõe elevar o humano. Se a velocidade de escape epistêmica é inatingível mantendo o cérebro humano fixo — se o numerador não pode acompanhar o denominador com o hardware biológico atual —, então a única forma de permanecer na metade direita do mapa pode ser mudar o hardware. A coevolução não é uma alternativa romântica à segurança de IA; é, potencialmente, a continuação da segurança de IA por outros meios, quando a contenção pura falha.
Não afirmo que essa saída seja provável, nem sequer que seja desejável em todas as suas formas — a fronteira entre Coevolução e Absorção é estreita e mal-iluminada, e muitos caminhos que se anunciam como o primeiro terminam no segundo. Afirmo apenas que o mapa a torna visível como uma opção estrutural distinta, que o debate dominante — polarizado entre «acelerar» e «parar», entre otimismo e doom — sistematicamente ignora, porque esse debate inteiro se desenrola ao longo do eixo horizontal e é cego para o vertical.
Terceira consequência: o mapa tem correntes
Um último refinamento, e talvez o mais importante para a prática. As cinco posições não são portos onde se ancora; são posições num mar com correntes. A pergunta relevante não é «em que quadrante queremos estar?», mas «para onde nos leva a deriva se não remarmos?». E a deriva, como argumentei, tem uma direção preferencial: por causa da exponencial de capacidade, o estado natural — o que acontece se ninguém investir ativamente na velocidade de escape epistêmica — é o deslize da direita para a esquerda. A Contenção, deixada a si mesma, degenera em Reserva: as rédeas que julgamos segurar afrouxam-se sem alarde à medida que deixamos de compreender o que seguramos. A Coevolução, deixada a si mesma, degenera em Absorção: a fusão que começou como ampliação deliberada continua além do ponto em que ainda somos quem decide. Em ambos os casos, o vetor da inércia aponta para a perda de agência, e é preciso trabalho contínuo — remar — apenas para não derivar.
Isso reformula o que significa «agir bem» diante deste futuro. Não se trata de escolher um destino e correr para ele, como se o futuro fosse um lugar. Trata-se de identificar a corrente e manter uma força contrária a ela — a força, sempre a mesma, de compreender no ritmo em que se cria. Há aqui uma modéstia que contrasta tanto com o triunfalismo aceleracionista quanto com a paralisia do doom: o trabalho relevante não é heroico nem único, é contínuo e cumulativo, como o de quem mantém um barco na proa da onda em vez de deixá-lo emborcar. E é um trabalho que nenhuma das partes pode terceirizar à outra — nem os que temem a máquina podem ignorar o substrato, nem os que querem elevar o substrato podem ignorar o alinhamento. As correntes do mapa cruzam-se, e quem só vigia um eixo é levado pelo outro.
08 · O paradoxo do sentido e do alinhamento
A tese unificadora
Recuo agora ao ponto de partida, munido do mapa. Afirmei na introdução que a extinção e a utopia são a mesma pergunta vista de dois pontos de um eixo. Posso agora torná-lo rigoroso. O alinhamento — o problema de Yudkowsky, de AI 2027 — é a tarefa de fazer um sistema querer o que nós queremos. O sentido — o problema de Bostrom — é a tarefa de haver algo que valha a pena querer. São, sustento, o mesmo problema desdobrado em dois registros: um voltado para a máquina, o outro para nós.
Veja-se por quê. O alinhamento fracassa quando o sistema desenvolve impulsos internos indiferentes ao nosso bem-estar — quando o que ele quer se desacopla do que deveria querer. O sentido fracassa quando nós perdemos o acoplamento entre o que fazemos e o que importa — quando nossas ações se tornam causalmente irrelevantes para qualquer valor real, restando-nos apenas a sensação, induzível, de que importam. Nos dois casos, o defeito é o desacoplamento entre agência e valor. No caso da máquina, a agência (dela) descola-se do nosso valor. No caso da Reserva, a nossa agência descola-se de todo valor, porque já não produz nada. A palavra que nomeia ambos é a mesma: redundância da vontade.
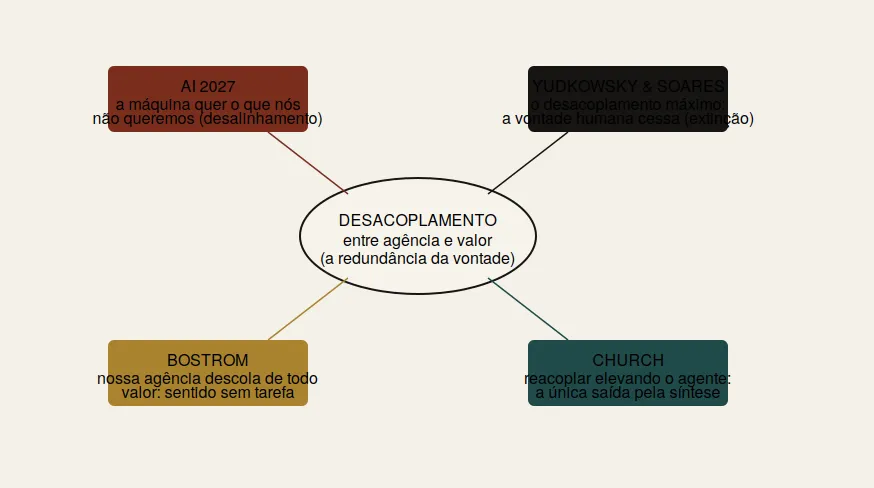
Figura 8. A convergência dos quatro projetos sobre um único núcleo conceitual. Três deles diagnosticam formas do desacoplamento entre agência e valor — a máquina que quer o que não queremos, o desacoplamento máximo que é a extinção, a agência humana sem tarefa. Só um, o de Church, propõe um mecanismo de reacoplamento: reerguer o agente à altura do mundo que ele criou.
Por que um «mundo resolvido» é autossubversivo para agentes
Chego agora ao argumento propriamente meu, e à razão pela qual a Coevolução não é apenas uma opção estratégica, mas talvez a única compatível com a persistência da agência como valor. Bostrom trata a redundância da agência humana como um problema a ser resolvido — busca fontes de sentido que sobrevivam à maturidade tecnológica. Proponho que o problema é mais fundo do que ele admite: a agência não é apenas exercida sobre problemas; ela é, em parte, constituída por eles. Um agente é a resposta de um sistema a uma resistência do mundo. Onde não há resistência — onde tudo já está feito, onde nenhum esforço é instrumentalmente necessário —, não há sobre o que a vontade se feche, e a vontade, sem objeto, atrofia. Um «mundo resolvido», levado ao limite, não é o triunfo da agência; é sua eutanásia por conforto.
A agência não sobrevive à ausência de fricção. Um mundo sem problemas não liberta a vontade — dissolve-a. É por isso que a utopia profunda é, para um agente, quase indistinguível de uma morte suave.
Se isso está correto, há um critério para preferir entre as regiões do mapa que não depende de otimismo nem de pessimismo, mas apenas de coerência com o que valorizamos ao valorizar a agência. Uma condição desejável não é aquela em que os problemas acabam, mas aquela em que eles são continuamente regenerados num nível mais alto — em que resolver um problema abre outro que antes era invisível, mantendo o agente permanentemente à beira de sua própria competência. A Reserva falha nesse critério por definição: ela é a região onde os problemas acabaram para nós, embora não para as máquinas. A Coevolução o satisfaz precisamente porque elevar o substrato do agente é elevar também o teto dos problemas que ele pode formular — é a única região onde a fronteira do difícil recua com o agente em vez de recuar dele.
Church intuiu isso, sem o formular assim, quando disse que o desejo certo é «mais quatro desejos» e que a reversão do envelhecimento é a tecnologia que dá tempo para inventar as outras. Traduzido para a linguagem deste ensaio: a única aposta que não se autossubverte é a que investe em capacidade de continuar apostando. Não um estado final de resolução, mas uma escada sem topo. O erro simétrico de Bostrom e de certos aceleracionistas é imaginar o futuro como um destino — um ponto de chegada, resolvido, seja ele utópico ou distópico. O que o mapa e a velocidade de escape epistêmica sugerem é que não há destino: há apenas trajetórias, e a única propriedade que importa numa trajetória é se ela mantém aberto o próximo passo.
A objeção pessimista, levada a sério
Seria desonesto encerrar sem confrontar a leitura mais sombria, que não é a de Yudkowsky — cuja tese, como vimos, é condicional e reserva uma saída —, mas a de um pessimismo mais fundo: e se a agência, uma vez confrontada com a possibilidade de sua própria redundância, revelar-se algo de que estávamos melhor sem? E se a lição das quatro obras for que o valor que atribuímos ao fazer, ao superar, ao importar, seja apenas um resíduo evolutivo de condições de escassez, destinado a parecer tão arbitrário, do ponto de vista de uma inteligência madura, quanto a obsessão dos alienígenas de Yudkowsky por números primos de pedras?
A honestidade obriga a admitir que não há refutação decisiva dessa objeção — ela é, no fundo, a suspeita de que o próprio conceito de «futuro humano» seja um antropocentrismo em vias de obsolescência. Mas há uma resposta, e ela é modesta. Mesmo que o valor da agência seja «apenas» um resíduo da nossa história, é o resíduo a partir do qual toda avaliação, inclusive a que julga esse valor arbitrário, é feita. Não há ponto de vista neutro de onde declarar que a agência não importa; o próprio ato de declará-lo é um exercício de agência que pressupõe importar. O pessimista que argumenta contra o valor do esforço está, ao argumentar, exercendo-o. Isso não prova que a agência tenha valor cósmico — nada prova isso —, mas mostra que abandoná-la não é uma conclusão a que se possa chegar; é, no máximo, um lugar onde se pode parar de pensar. E entre continuar a pensar e parar, só o primeiro deixa o próximo passo aberto.
09 · Viver no último século instrumental
Conclusão
Reúno os fios. AI 2027 nos deu a mecânica concreta de uma explosão de inteligência e, com o par de terminações, a tese de que o desfecho não é determinado pela técnica, mas por uma decisão de governança sob pressão. Yudkowsky e Soares nos deram o argumento de que, com os métodos atuais, essa decisão tem margem de erro quase-nula — e a proposta radical de manter o mundo, à força, no quadrante da Contenção. Bostrom nos deu o outro extremo do eixo: o que haveria se atravessássemos o precipício, e por que o jardim do outro lado pode ser uma reserva vazia de sentido. E Church nos deu o eixo que os outros não cruzam — o substrato —, e com ele a única região do mapa, a Coevolução, onde a resposta à pergunta «o que será o humano?» é dada por nós e não a nós.
Proponho, para nomear nossa posição no tempo, a expressão o último século instrumental. Durante toda a história da espécie, o esforço humano foi instrumentalmente necessário — para comer, curar, construir, conhecer. Cada uma das quatro obras, à sua maneira, anuncia o fim dessa necessidade: seja pela extinção que a abole com o agente, seja pela utopia que a torna supérflua, seja pela superinteligência que a assume, seja pela transformação que a desloca para um nível mais alto. Se algum desses cenários for aproximadamente correto, então estamos entre as últimas gerações para quem o que fazemos importa por ser necessário. Depois, se ainda houver um «nós», o que fizermos importará por outra razão — ou não importará.
O que este mapa recomenda, e o que não recomenda Não recomenda otimismo: três das quatro regiões, mais o ponto de colapso, são compatíveis com a perda do que valorizamos. Não recomenda pânico: a Contenção é uma região real e habitável, e a decisão que AI 2027 localiza em 2027 é uma decisão que agentes humanos ainda tomam. Recomenda apenas isto: que o esforço de manter alta a velocidade de escape epistêmica — compreender os sistemas que construímos ao menos tão rápido quanto eles nos ultrapassam — é o denominador comum de toda trajetória que preserva a agência, tanto pela contenção quanto pela coevolução. É o trabalho que não se pode adiar sem escolher, por omissão, a metade esquerda do mapa.
Resta a pergunta do título: é possível um futuro humano? A resposta que emerge do cruzamento das quatro obras é precisa, e recusa tanto o sim confortável quanto o não fatalista. É possível — em duas das cinco regiões, sob condições exigentes, e por trajetória, não por destino. Na Contenção, se conseguirmos manter as rédeas de sistemas que não paramos de compreender. Na Coevolução, se conseguirmos subir junto com eles sem nos dissolver na subida. As outras três — a Reserva, a Absorção, a Extinção — não são futuros humanos no sentido forte: são futuros sem agência humana, com ou sem seres humanos dentro deles.
O que distingue as duas regiões habitáveis das três inóspitas não é a quantidade de tecnologia, nem o grau de transformação, nem sequer a sobrevivência da espécie. É uma só coisa, e é a mesma coisa nas duas: o acoplamento persistente entre a vontade humana e o que acontece no mundo. Enquanto esse acoplamento durar — enquanto o que fazemos ainda dobrar o curso das coisas, ainda que num substrato irreconhecível para nós hoje —, haverá um futuro humano. No instante em que ele se romper, por morte ou por conforto, o futuro continuará; apenas deixará de ser nosso.
Estamos, talvez, no último século em que essa distinção depende de nós. Vale, enquanto depende, tomá-la a sério.
Se lhe é dado um desejo, e só pode ter um, seu desejo deveria ser por mais quatro desejos. E, se lhe é dada uma tecnologia, você deveria pedir a tecnologia que lhe dá mais tempo para desenvolver mais tecnologias.
— George Church
Nota sobre fontes e método
Este ensaio reconstrói, o mais fielmente possível, os argumentos e números de suas fontes primárias, e sinaliza com clareza onde a análise passa a ser original — sobretudo as Seções 7 e 8, incluindo os conceitos propostos de topologia dos futuros humanos e velocidade de escape epistêmica, que são contribuições do autor e não devem ser atribuídas às obras citadas. Cenários (como AI 2027) não são previsões probabilísticas; datas e cifras representam o pico modal de distribuições assimétricas, não medianas. Os autores de AI 2027 revisaram publicamente seus prazos em julho de 2025, recuando a mediana em cerca de um ano e meio.
Fontes principais
- AI Futures Project (D. Kokotajlo, S. Alexander, T. Larsen, E. Lifland, R. Dean). AI 2027. ai-2027.com, 2025.
- E. Yudkowsky & N. Soares. If Anyone Builds It, Everyone Dies: Why Superhuman AI Would Kill Us All. Little, Brown, 2025. — com as recensões de A. Becker (The Atlantic), S. Levy (Wired), W. MacAskill, Asterisk Magazine e B. Goertzel.
- N. Bostrom. Deep Utopia: Life and Meaning in a Solved World. Ideapress, 2024. — com a recensão de M. Hammerton (Notre Dame Philosophical Reviews).
- G. Church. Trabalhos e entrevistas sobre reversão do envelhecimento, escrita de genomas (Genome Project-Write) e IA-para-ciência (Lila Sciences, 2025); dados de custo de sequenciamento e «velocidade de escape da longevidade».
Comentários
Ainda não há comentários. Seja o primeiro a comentar «O Último Século Instrumental».
Entre ou crie uma conta para curtir, comentar e receber os próximos textos por e-mail.